Deterministische Sub-Agent Orchestration mit Claude Mods
Eine Regel zur Delegation, die im Prompt steht, ist eine Empfehlung: Das Modell wägt sie gegen alles andere im Context ab und kann sich darüber hinwegsetzen. Ein Mod setzt dieselbe Regel bei jedem Agent Call als Code durch. Jede Aufgabe geht an den Sub-Agent, dessen Tools zu ihr passen, und läuft auf dem günstigsten Modell, das sie lösen kann.
Teil 1: Der Mod bringt jede Aufgabe zum passenden Specialist und Modell
Spezialisierte Sub-Agents liefern bessere Arbeit zu niedrigeren Kosten
Drei Dinge bestimmen einen Sub-Agent: sein Prompt mit Anweisungen, Skills und House Rules, seine Tools wie der MCP Server der Angular CLI und Chrome DevTools und sein Modell. Ein Specialist, bei dem diese Konfiguration stimmt, arbeitet besser und günstiger als ein General-purpose Agent.
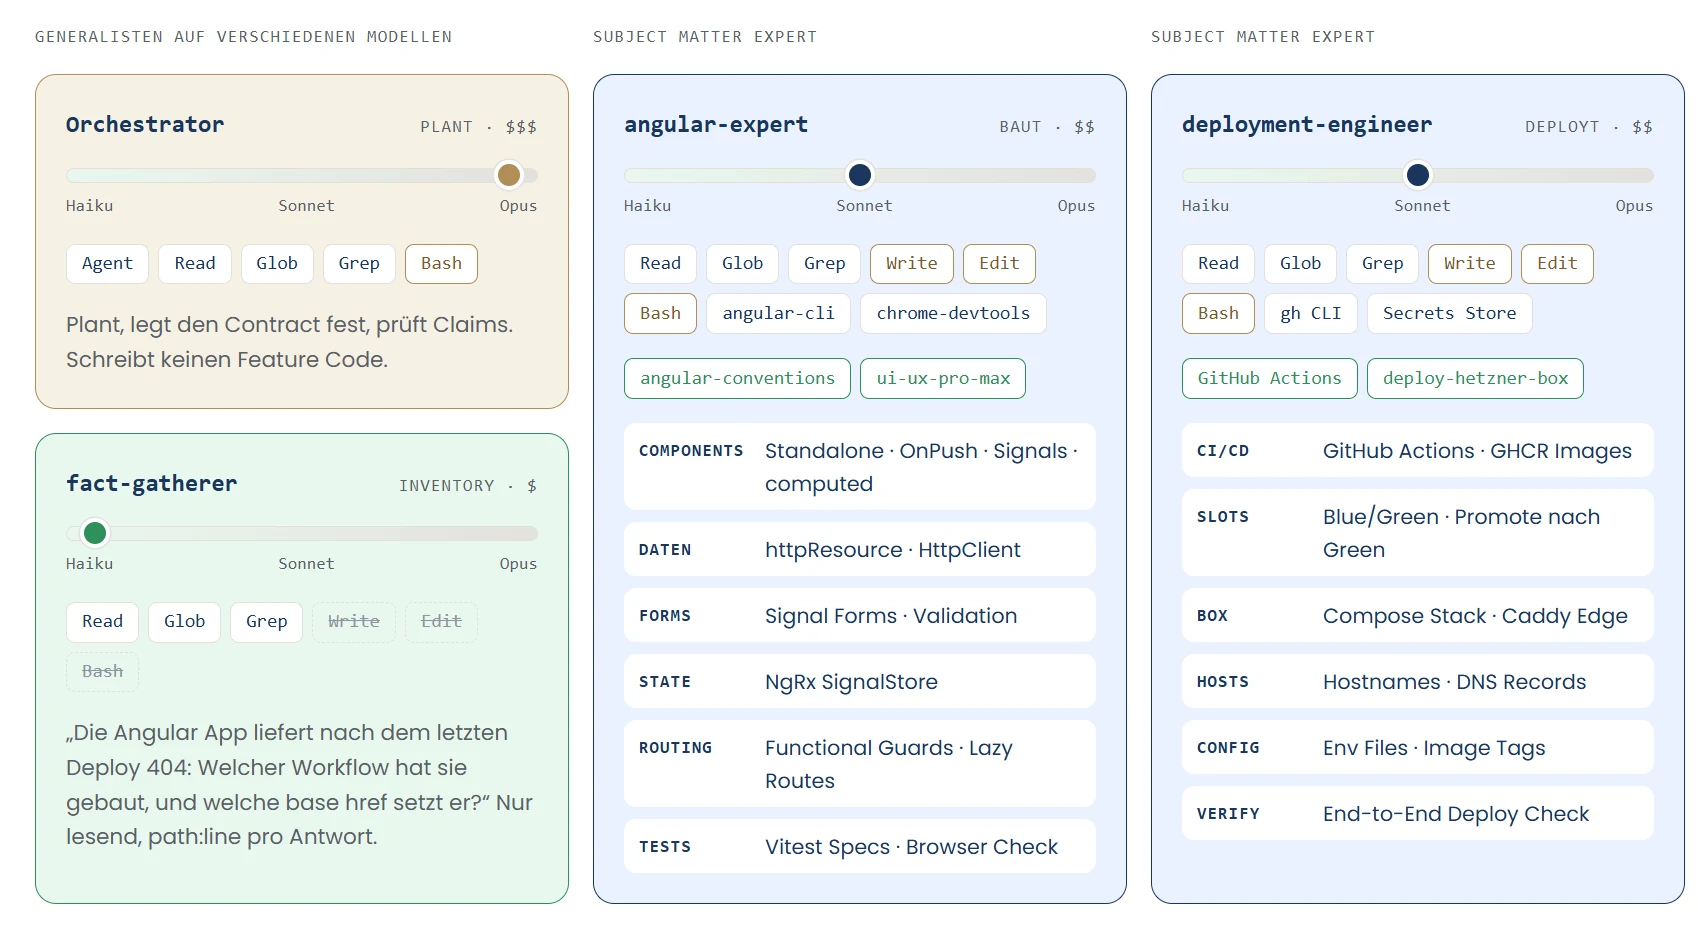
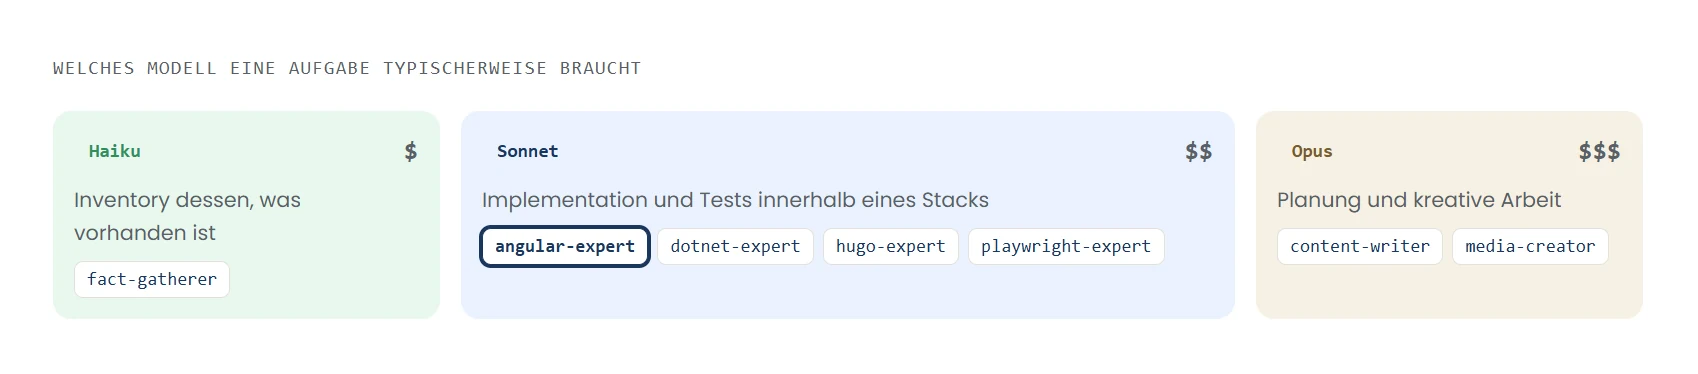
Der Orchestrator plant auf Opus, der fact-gatherer erstellt auf Haiku ein Inventory dessen, was vorhanden ist, angular-expert und deployment-engineer arbeiten auf Sonnet mit den Tools und Skills ihres Stacks. Für ein Inventory reicht das günstige und schnelle Haiku 5.5. Sonnet übernimmt Implementation und Tests innerhalb eines Stacks, Opus die Planung und kreative Arbeit.
Wie das abläuft, zeigt eine einfache Two-Tier App, von der Anfrage bis zum geprüften Ergebnis: „Feld X zu Liste Y hinzufügen“. Ein Inventory auf Haiku sammelt die Fakten, von denen der Contract abhängt, je ein Specialist auf Sonnet setzt die Hälfte seines Tier um, und Opus plant und prüft. Jeder Schritt läuft auf dem günstigsten Modell, das ihn schafft. Der Contract steht in einem gemeinsamen Ledger, aus dem jeder Agent dieselben Fakten liest. So geht kein Detail verloren, wenn Zusammenfassungen von Agent zu Agent wandern, und ein Prozess, der abbricht, etwa weil ihm die Token ausgehen oder sein Cache verfällt, setzt beim Stand im Ledger wieder auf.
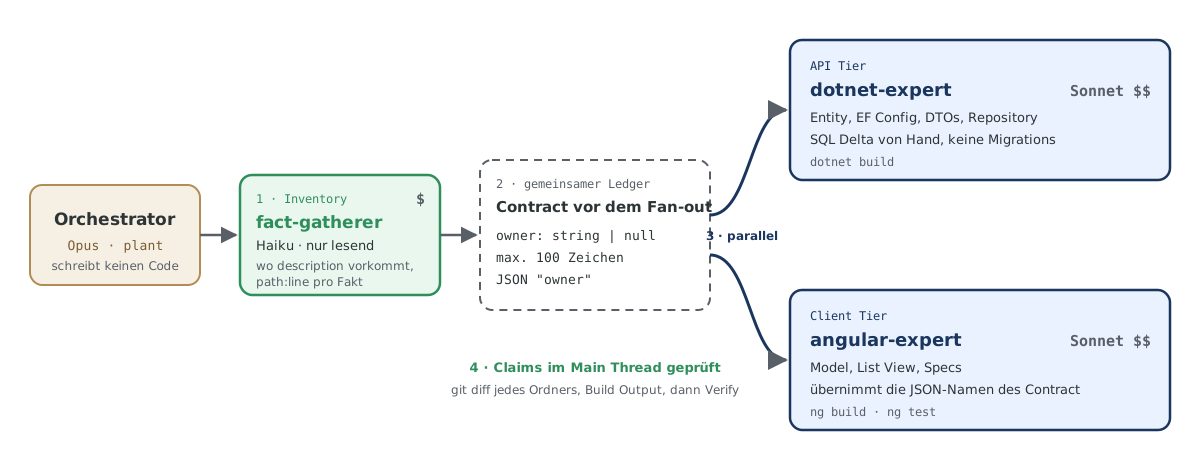
Der Ablauf hat vier Schritte. Zuerst sucht der fact-gatherer auf Haiku jede Stelle im Code, an der das Feld vorkommt, und meldet sie mit Datei und Zeile. Daraus legt der Orchestrator den Contract im Ledger fest, im Beispiel ein Feld owner, Text oder leer, höchstens 100 Zeichen. Dann setzen dotnet-expert im API Tier und angular-expert im Client Tier parallel auf Sonnet um. Zum Schluss prüft der Main Thread ihre Claims an Diff und Build.
Mit dem Agent wählen Sie sein Modell samt Kosten sowie seine Expertise: System Prompt und Tools, etwa die Angular CLI für angular-expert oder die gh CLI für deployment-engineer, entscheiden, wie gut die Arbeit wird.
Ob eine Regel zur Delegation greift, entscheidet das Modell
Ob Claude Code eine Aufgabe delegiert und an wen, entscheidet das Modell anhand von Prompt-Text. Eine Agent Description erhöht nur die Wahrscheinlichkeit einer Delegation. So landet Angular-Arbeit, die angular-expert auf Sonnet erledigen würde, bei einem General-purpose Agent. Der übernimmt das Opus-Modell des Orchestrator, und ihm fehlen die passenden Tools wie der MCP Server der Angular CLI und Chrome DevTools. Das Ergebnis hält sich nicht an die Standards, die im Specialist festgelegt sind, stimmt oft nicht, und die Token werden ineffizient eingesetzt.
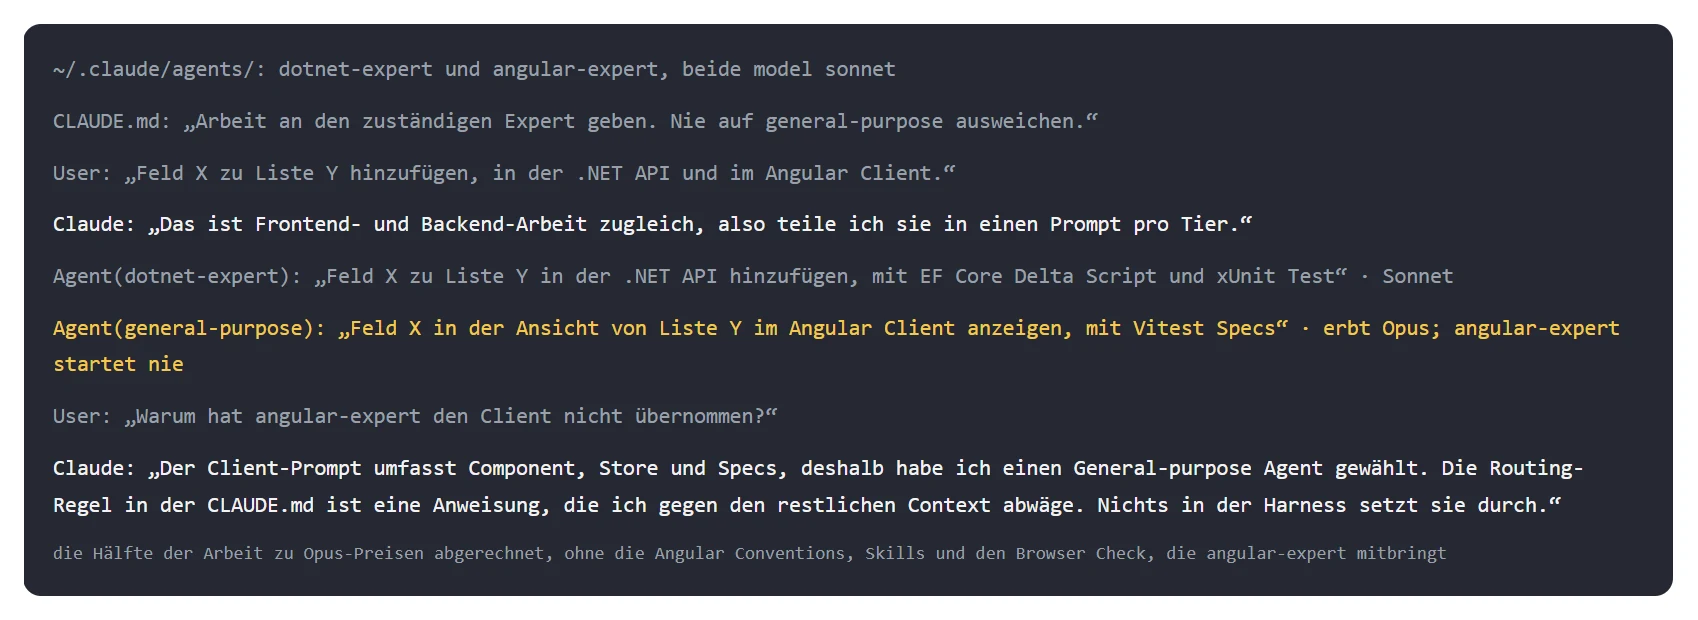
Im Beispiel verlangt die CLAUDE.md, Arbeit an den zuständigen Specialist zu geben. Claude gibt die API an dotnet-expert auf Sonnet und den Client-Prompt an einen General-purpose Agent, der Opus übernimmt; angular-expert startet nie. Auf Nachfrage erklärt Claude selbst, warum: Die Regel in der CLAUDE.md ist eine Anweisung, die es gegen den restlichen Context abwägt, und nichts in der Harness setzt sie durch.
Hooks halten die CLAUDE.md kurz und wiederholen ihre Regeln vor jedem Prompt
Vor den Mods standen die Regeln zur Delegation wie eine Verfassung in der CLAUDE.md, und Hooks setzten sie durch. claude-md-guard.sh sorgte dafür, dass die Claude Constitution nicht unnötig aufgebläht wurde. delegation-reminder.sh brachte vor jedem Prompt den Skill Check und die Regeln zur Delegation erneut in den Context, gegen Context Decay: In einer langen Session verlieren frühe Anweisungen an Gewicht, je mehr neuer Text in den Context kommt.
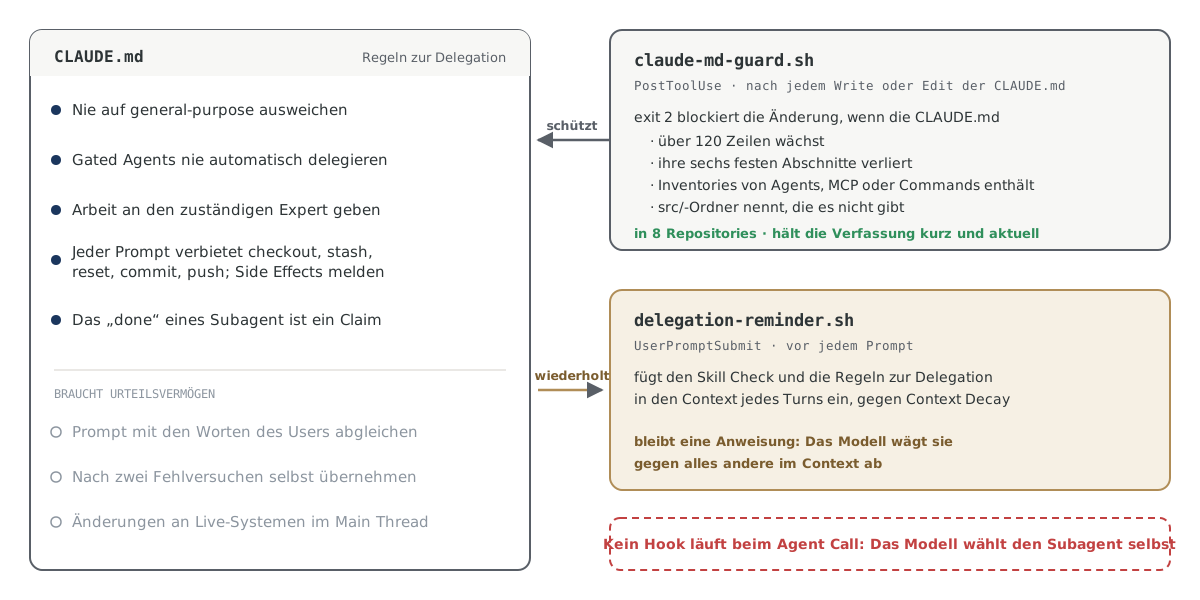
Fünf der Regeln in der CLAUDE.md lassen sich prüfen und damit durchsetzen, drei brauchen Urteilsvermögen.
Ein Mod setzt die Regeln zur Delegation bei jedem Agent Call als Code durch
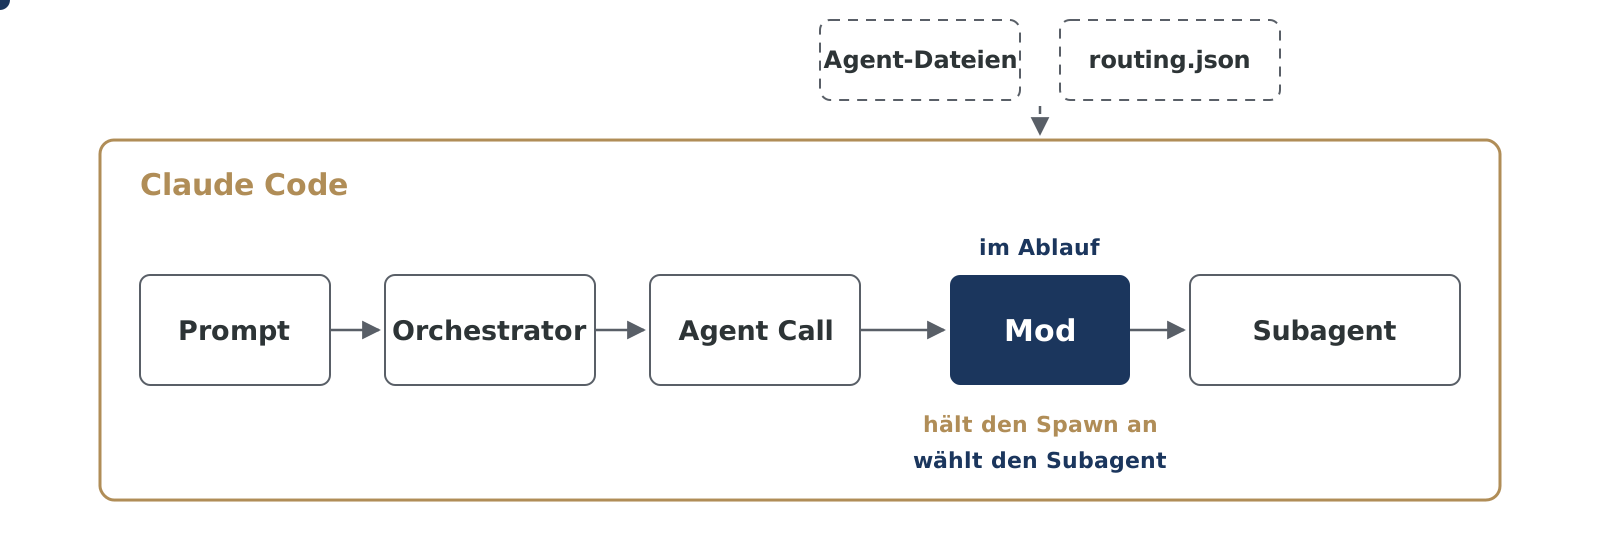
Der Mod fängt jeden Agent Call ab, bevor der Sub-Agent startet. Er hält den Spawn an und bestimmt den Ziel-Agent aus den Agent-Definitionen und der routing.json. Jeder potenzielle Delegationsfehler landet im Log, und unser Learning Loop stellt sicher, dass er in Zukunft nicht mehr auftritt. So läuft jede Session mit denselben Regeln. Was Mods in der Harness sonst leisten, beschreibt der Artikel Agentic Software Engineering mit Mods optimieren .
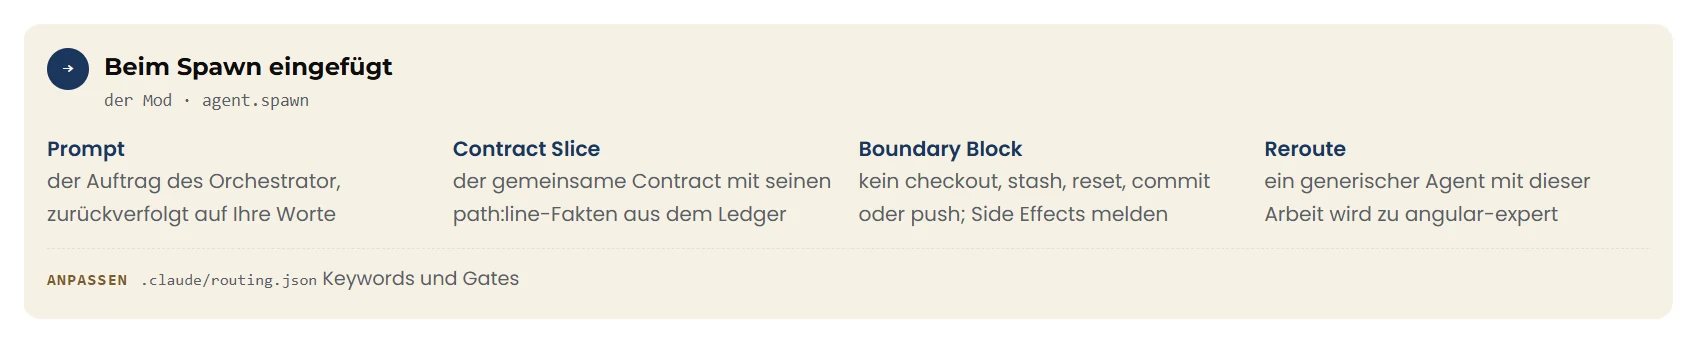
Bevor ein Sub-Agent startet, gibt ihm der Mod vier Dinge mit: den Prompt mit Ihrem Auftrag, den Teil des Contract, den er umsetzen soll, einen Boundary Block mit den Aktionen, die er nicht ausführen darf, und bei Bedarf den Reroute zum zuständigen Specialist. So startet jeder Sub-Agent unter denselben Regeln, egal wie lange die Session schon läuft.
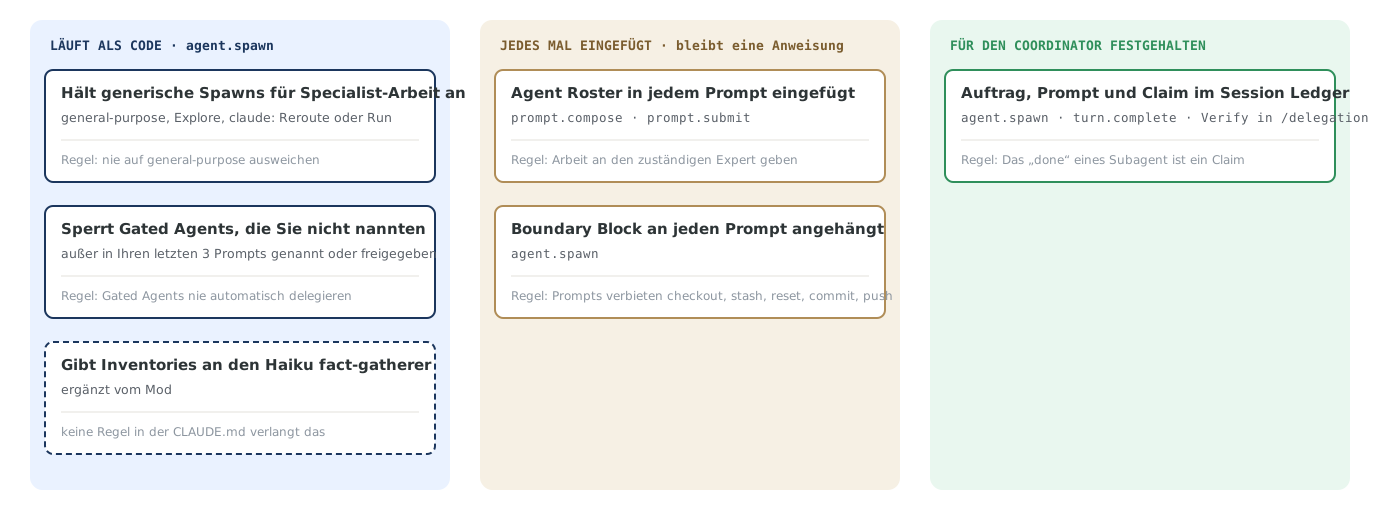
Drei Regeln setzt der Mod als Code durch: Er hält einen generischen Spawn an, wenn ein Specialist für die Arbeit zuständig ist, er sperrt Gated Agents, die Sie nicht genannt haben, und er schickt jedes Inventory an den fact-gatherer auf Haiku. Den Roster der Agents fügt er in den System Prompt ein, den Boundary Block in jeden Prompt; beides bleibt eine Anweisung an das Modell. Auftrag, Prompt und Claim jedes Sub-Agent hält er für den Orchestrator im Ledger fest.
Derselbe Prompt landet bei jedem Spawn beim selben Specialist
Zurück zum Beispiel mit dem neuen Feld: Der Prompt für den Angular Client, der beim General-purpose Agent gelandet war, läuft jetzt durch den Mod. Der hält ihn an und routet ihn zu angular-expert auf Sonnet um.
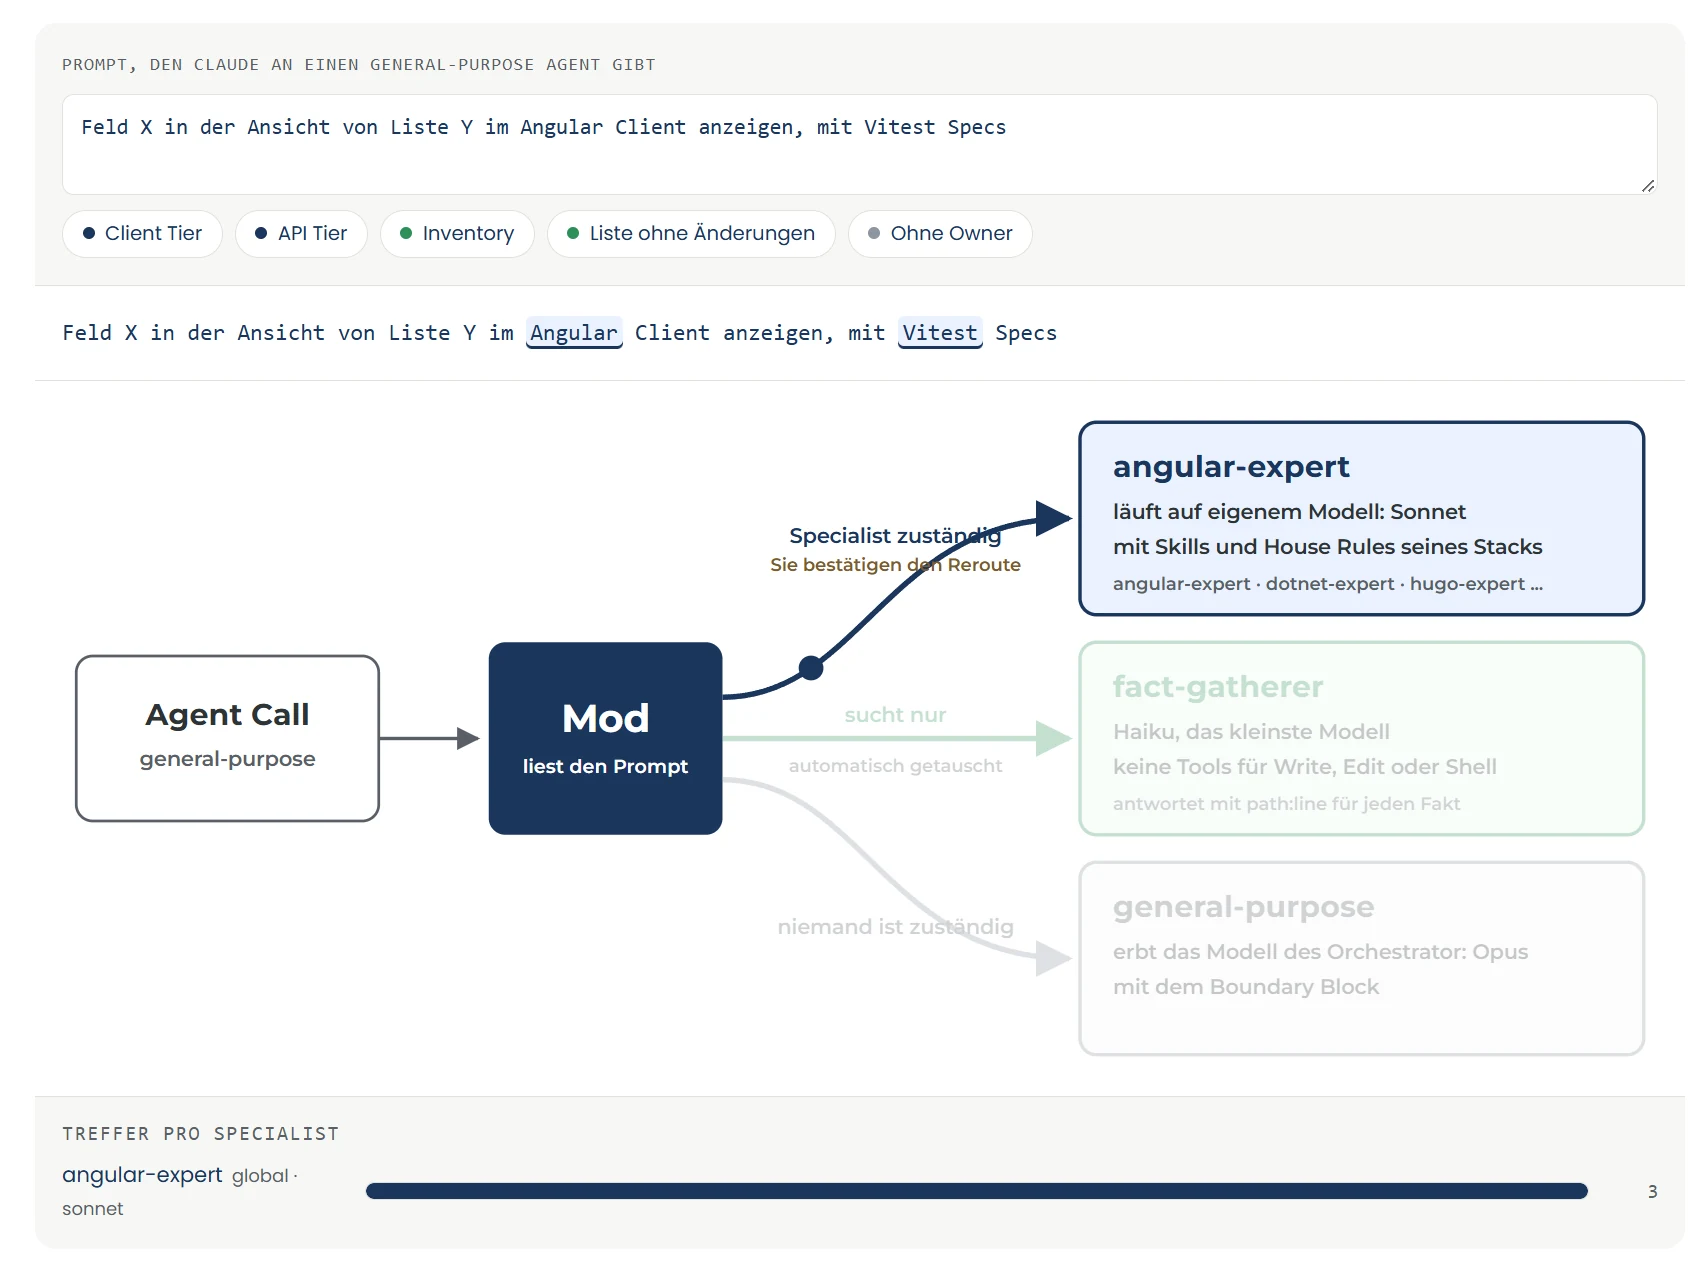
Der Mod liest den Client-Prompt, erkennt darin Angular und Vitest und routet den Agent Call zu angular-expert, der auf Sonnet mit den Skills seines Stacks arbeitet. Den Reroute bestätigen Sie.
Die Tabelle zeigt fünf Prompts und den Agent, zu dem der Mod jeden davon routet. Ein Prompt, der Code ändert, landet beim Specialist seines Stacks, ein Inventory beim fact-gatherer auf Haiku. Ist für eine Aufgabe kein Specialist zuständig, bleibt sie beim General-purpose Agent.
| Beispiel | Prompt | Ziel-Agent |
|---|---|---|
| Client Tier | „Show field X in the list Y view of the Angular client, with Vitest specs“ | angular-expert |
| API Tier | „Add field X to list Y in the .NET API, with an EF Core delta script and an xUnit test“ | dotnet-expert |
| Inventory | „Find out where list Y is defined and used, in the API and the client“ | fact-gatherer |
| Liste ohne Änderungen | „List every file that touches list Y, do not edit anything“ | fact-gatherer |
| Ohne Owner | „Rename field X in the helper script“ | general-purpose |
Weil der Mod bei jedem Agent Call nach denselben Regeln routet, landet derselbe Prompt immer beim selben Specialist und auf demselben Modell. Damit können wir von deterministischer Orchestration ausgehen.
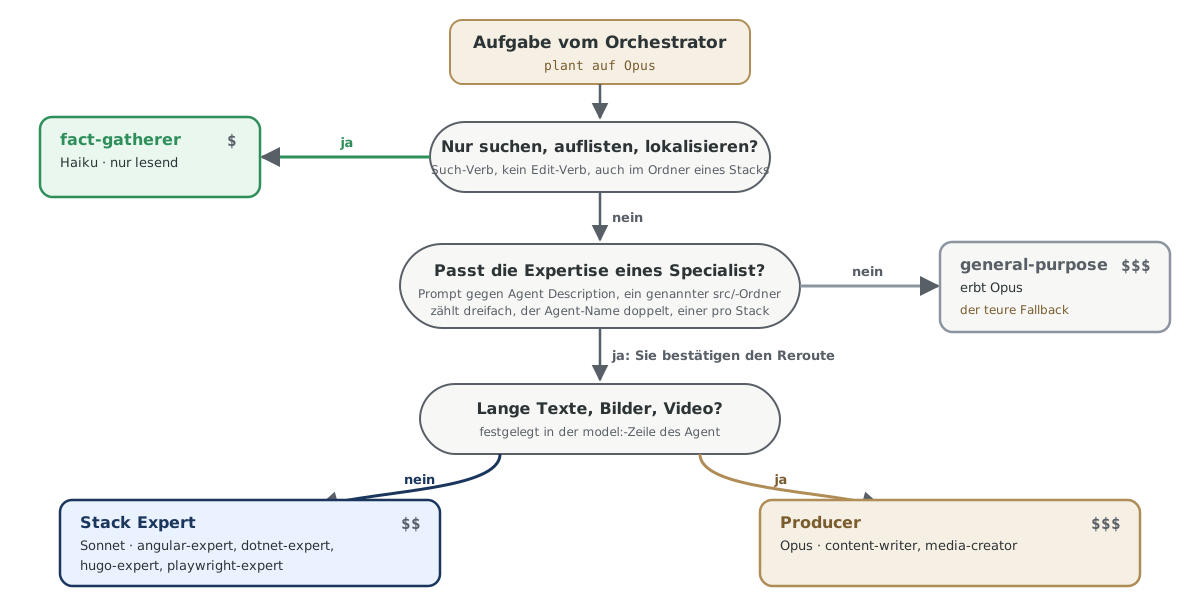
Jede Aufgabe des Orchestrator durchläuft dieselben Fragen. Soll sie nur etwas finden oder auflisten, geht sie als Inventory an den fact-gatherer auf Haiku. Passt die Expertise eines Specialist, entscheidet die Art der Arbeit: Code geht an einen Stack Expert auf Sonnet, lange Texte, Bilder und Video gehen an einen Producer auf Opus. Ist niemand zuständig, übernimmt der General-purpose Agent auf Opus, der teuerste Weg.
Teil 2: Optimierungen senken Kosten und Delegationsfehler weiter
Doch hier endet die Optimierung unserer Harness Architecture noch nicht. Drei weitere Schritte senken Kosten und Delegationsfehler:
- Ein Graph Ledger , der die Kosten umso stärker senkt, je mehr Agents am selben Contract arbeiten
- Ein Learning Loop , der Delegationsfehler in der Session abfängt und ihre Ursache danach behebt
- Ein /delegation Command und Side-Pane , eine UI Extension, die uns zusätzliche Informationen liefert, während die Harness läuft
Der Graph Ledger spart mit jedem weiteren Consumer eines Contract mehr
Jede Session führt einen gemeinsamen Agent Ledger, die Datei agent-ledger.md im Scratchpad der Session. Schreiben darf nur der Main Thread: pro Agent den Prompt, den Claim, also seine Meldung, dass die Arbeit fertig ist, den Nachweis, dass jemand diese Meldung geprüft hat, und die Side Effects, also alles, was der Agent außerhalb der geänderten Dateien verändert hat, etwa gestartete Server, installierte Packages oder neue Rows in der Datenbank. Nachträglich gestartete Sub-Agents bekommen ihren Prompt aus diesem Ledger. Was ein Agent schon geprüft hat oder was sich als Irrweg herausgestellt hat, muss kein weiterer Agent noch einmal herausfinden, und die Token dafür zahlen Sie nur einmal.
Der einfachste Ledger ist eine Markdown-Datei, eine log-artige Liste, in der jeder Eintrag unter dem vorigen steht. Beziehungen zwischen den Einträgen kennt sie nicht. Welcher Fakt zu welchem Contract gehört und welcher Specialist welchen Teil davon braucht, sucht der Orchestrator selbst zusammen und wiederholt es in jedem Prompt von Hand. Ein Graph speichert diese Beziehungen mit: Fakten, Contract und Agents sind verknüpft, und jeder Agent bekommt gezielt den Teil, den er braucht. So arbeiten auch GraphRAG und Agent Memory.
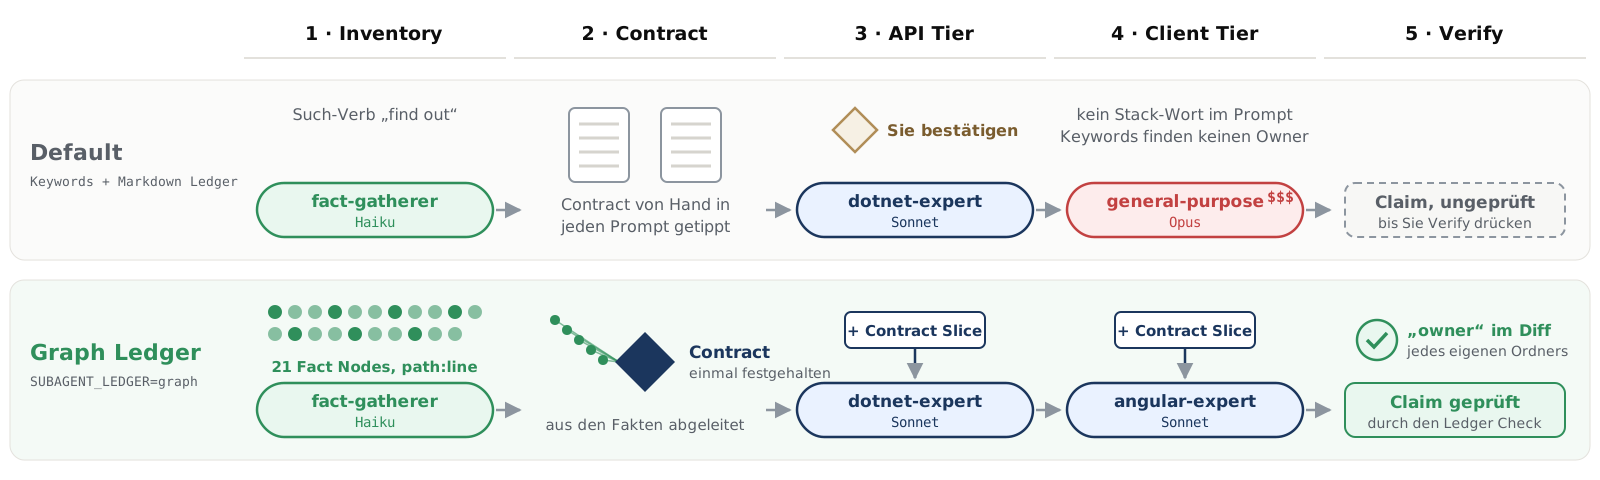
Mit Markdown Ledger tippt der Orchestrator den Contract von Hand in jeden Prompt, und ein Client-Prompt ohne Stack-Wort landet als General-purpose Agent auf Opus. Mit Graph Ledger entstehen aus dem Inventory 21 Fakten, daraus einmal der Contract, und dotnet-expert und angular-expert bekommen beim Spawn ihren Teil davon. Als geprüft gilt ein Claim erst, wenn der Ledger Check den Diff bestätigt.
Unsere Frage war, ob ein Graph Ledger die Effizienz noch weiter steigern kann. Erwartet hatten wir keinen Gewinn bei einem Contract mit zwei Consumers. Die Messungen haben das bestätigt und zugleich gezeigt, dass die Einsparung mit jedem weiteren Consumer wächst. Alle Zahlen in diesem Abschnitt stammen aus gemessenen Läufen.
Gemessen haben wir drei Aufgaben mit je drei Läufen pro Variante (Markdown Ledger und Graph Ledger). Jeder Lauf war eine eigene Claude Code Session ohne Eingriff, mit dem Orchestrator auf Opus und in einer frischen Kopie des Repositories. Die Kosten pro Lauf sind die Kosten, die Claude Code für die Session ausweist; die Token haben wir pro Modell aus den Transcripts aller Agents addiert. Gleiche Qualität heißt: Jeder Layer enthält die Änderung, und alle Builds sind grün. Runtime Tests gehörten nicht zur Messung, und einen Client, dessen Build schon vor den Läufen fehlschlug, haben wir aus der Bewertung genommen.
Getestet haben wir außerdem Jev als Decision Layer, der vor dem LLM den Agent für einen Prompt wählt. Jev brachte in unseren Läufen keinen Vorteil bei der Performance, deshalb haben wir die Messungen dem Artikel nicht beigelegt.
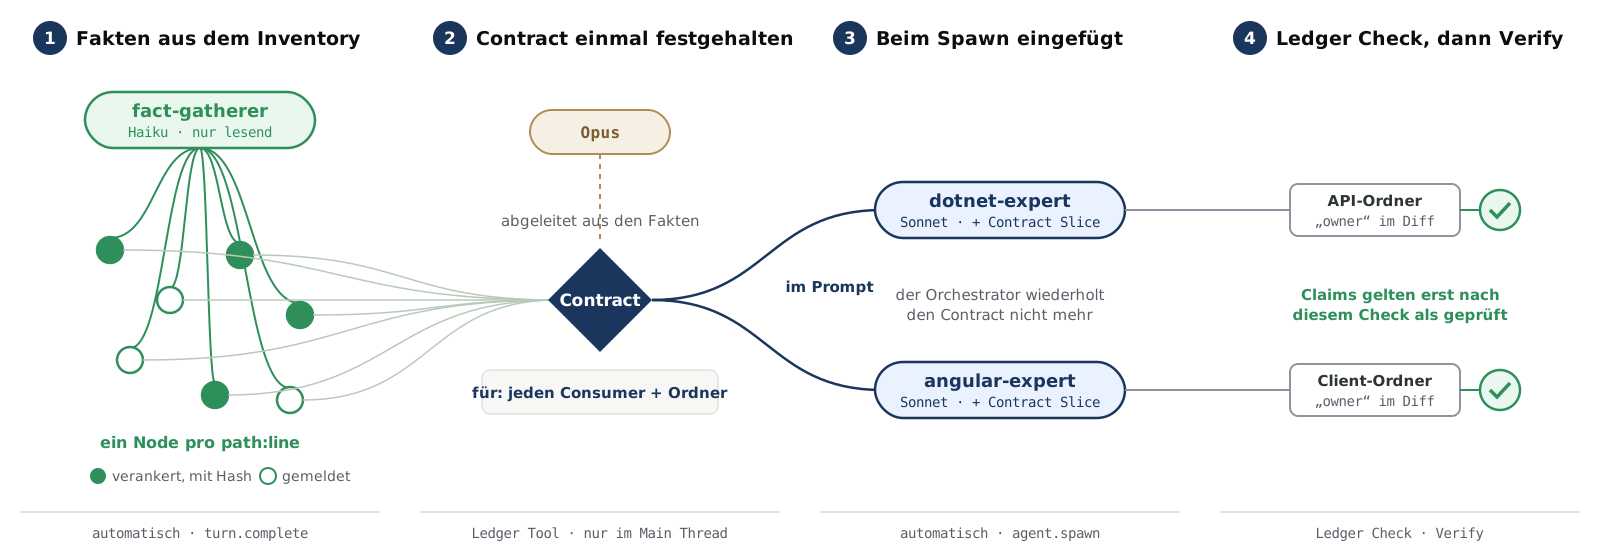
Der Graph Ledger arbeitet in vier Schritten. Zuerst meldet der fact-gatherer auf Haiku, was er im Code gefunden hat, und jede Fundstelle wird ein eigener Fakt im Graph. Daraus leitet der Orchestrator auf Opus einmal den Contract ab und legt fest, welcher Agent welchen Teil davon umsetzt. Beim Spawn bekommen dotnet-expert und angular-expert auf Sonnet nur ihren Teil, den Contract Slice, und der Orchestrator muss den Contract nicht mehr in jeden Prompt schreiben. Zum Schluss prüft der Ledger Check im Diff jedes Ordners, ob das neue Feld wirklich dazugekommen ist. Erst dann gilt der Claim eines Agent als geprüft.
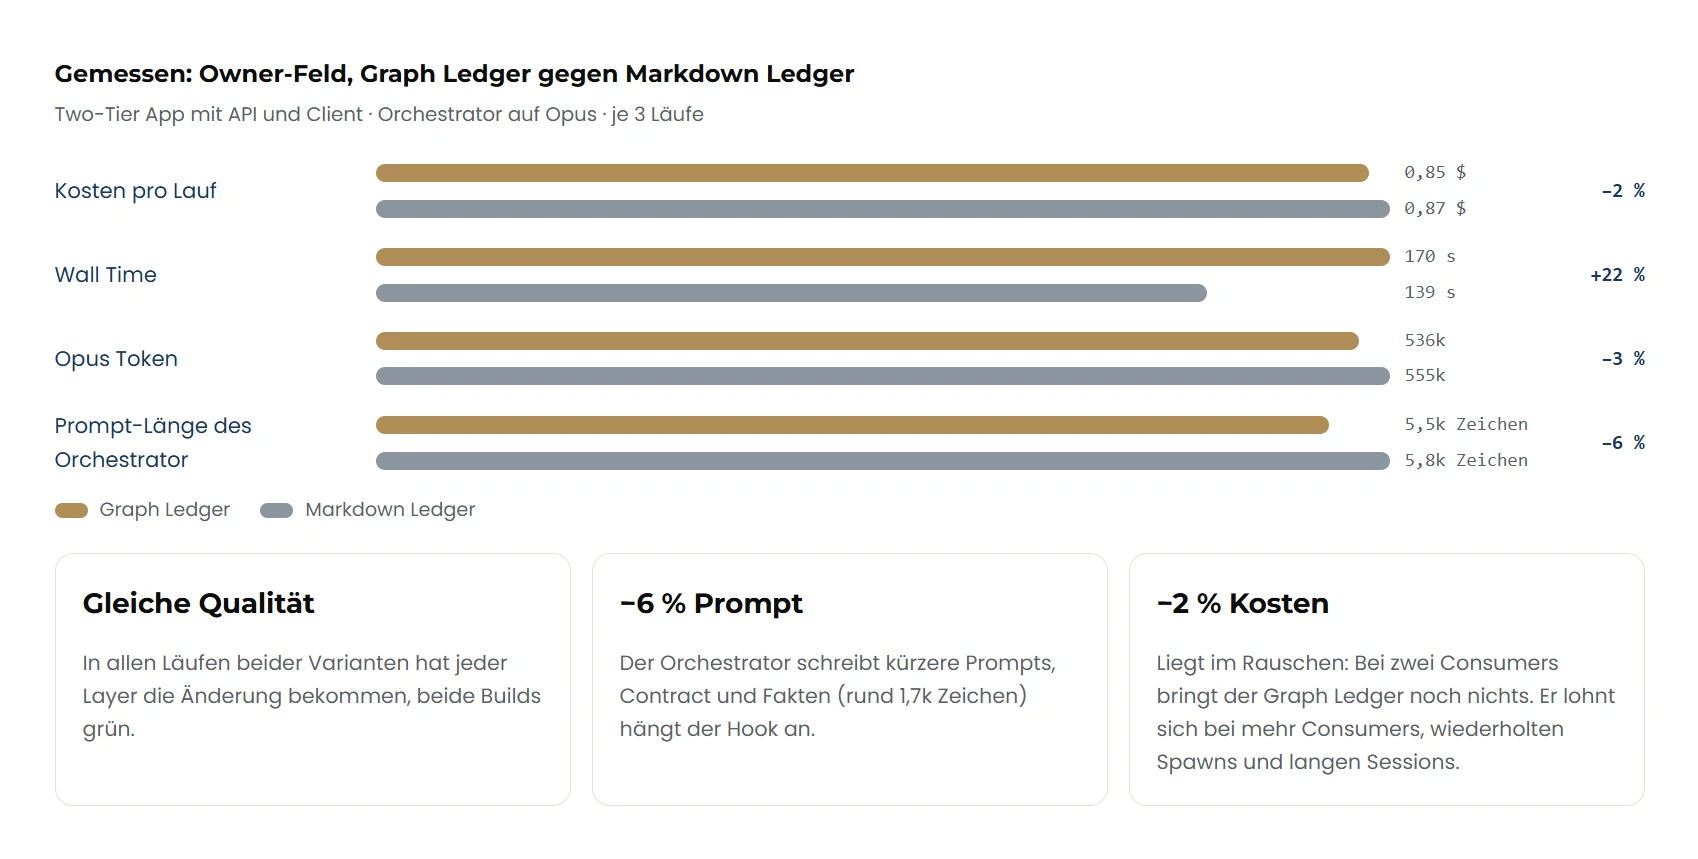
Bei zwei Consumers liegt der Kostenunterschied von 2 % im Rauschen, ein Lauf mit Graph Ledger dauert 22 % länger, und die Qualität ist in beiden Varianten gleich. Der fact-gatherer fand dabei pro Lauf im Schnitt 21 Fakten, also Stellen im Code, auf denen der Contract aufbaut.
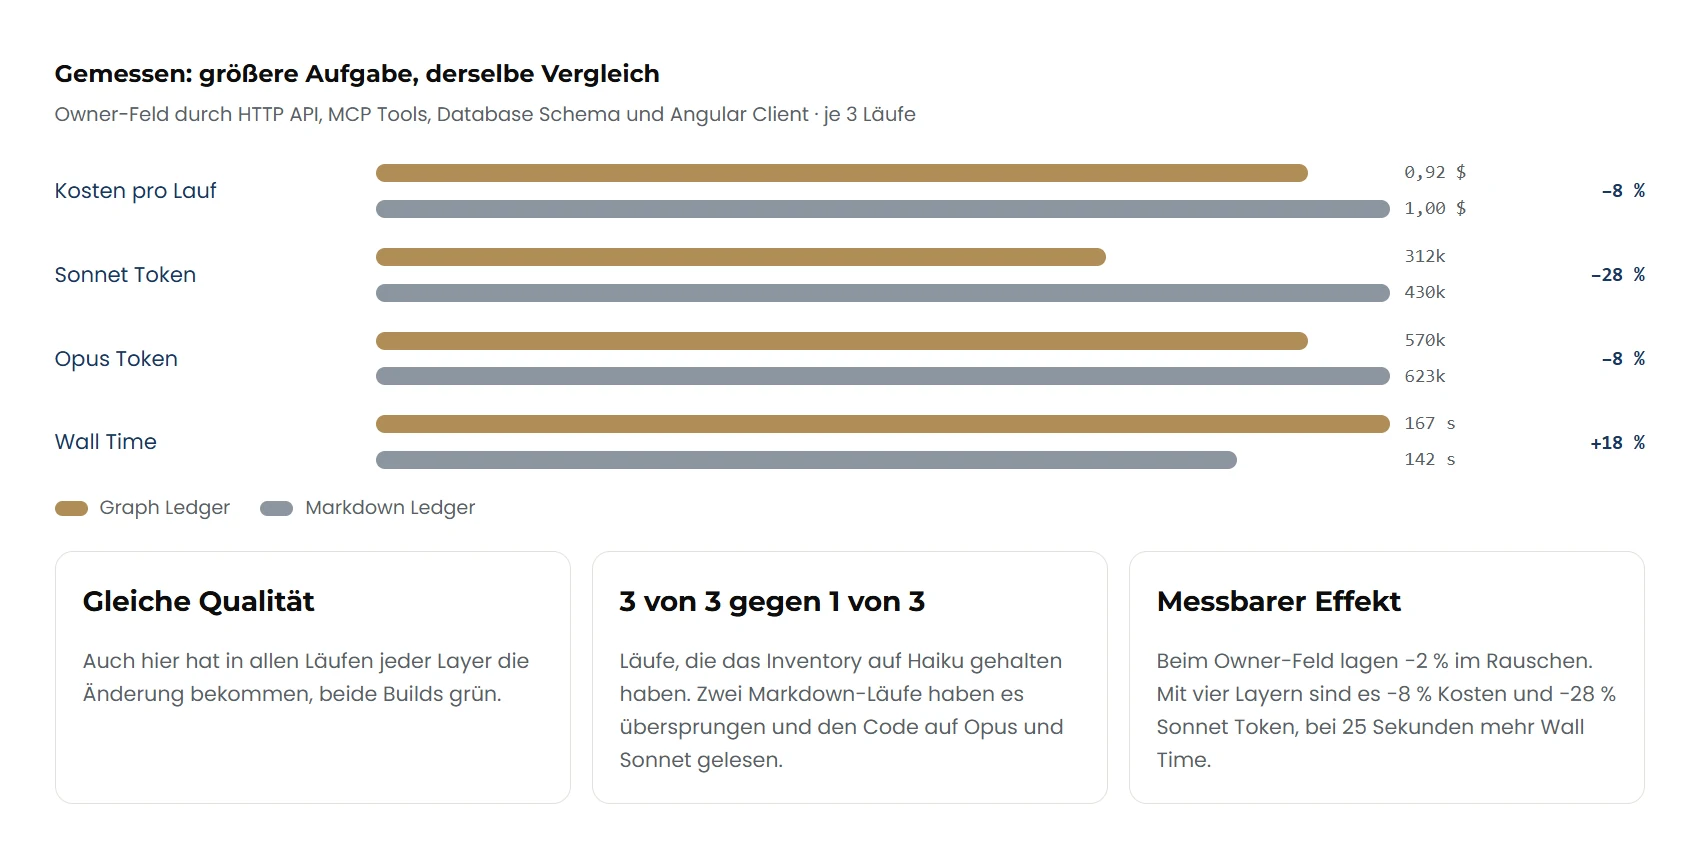
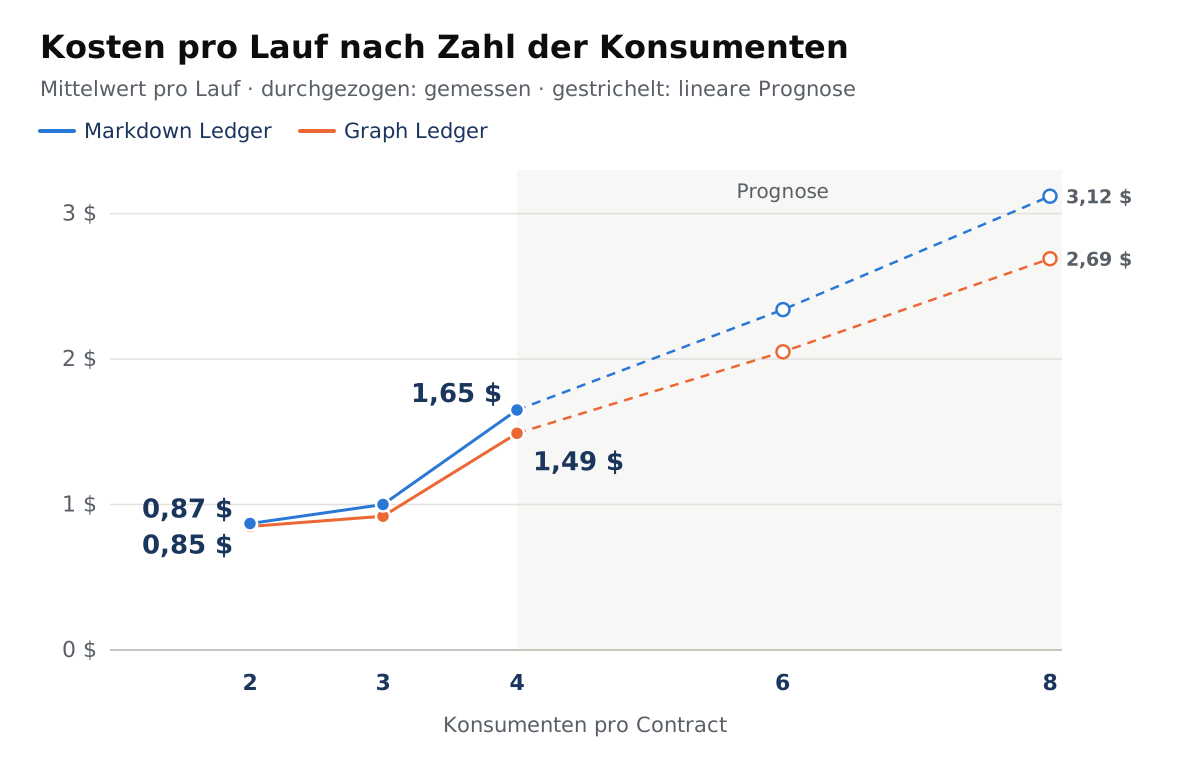
Der Kostenvorteil wächst mit der Zahl der Konsumenten. Bei zwei Agents am selben Contract liegen beide Ledger fast gleichauf, bei vier kostet ein Lauf mit Graph Ledger 1,49 Dollar, mit Markdown Ledger 1,65 Dollar.
| Consumers | Markdown Ledger | Graph Ledger |
|---|---|---|
| 2 | 0,87 $ | 0,85 $ |
| 3 | 1,00 $ | 0,92 $ |
| 4 | 1,65 $ | 1,49 $ |
| 6 (Prognose) | 2,34 $ | 2,05 $ |
| 8 (Prognose) | 3,12 $ | 2,69 $ |
Der Graph Ledger spart 2 % bei zwei Consumers, 8 % bei drei und 10 % bei vier. Die lineare Prognose kommt auf 13 % bei sechs und 14 % bei acht. Drei Aufgaben sind wenige Messpunkte, der gestrichelte Teil ist deshalb eine Prognose. In jedem Lauf aller drei Aufgaben hat jeder Layer die Änderung bekommen, und beide Builds waren grün. Bei der Aufgabe mit vier Consumers überlappen sich die Kosten der einzelnen Läufe, die 10 % dort sind ein Trend.
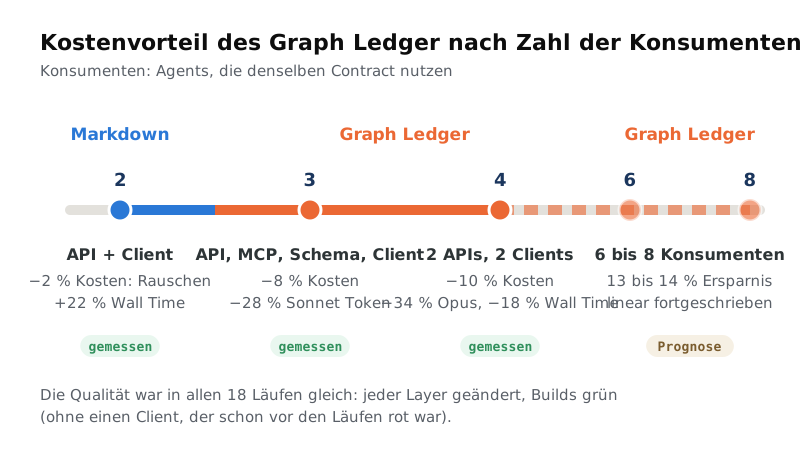
Bei zwei Konsumenten reicht deshalb der Markdown Ledger, ab drei lohnt sich der Graph Ledger.
Delegation Learning Loop
Eine Harness, die aus ihren eigenen Fehlern lernt, ist heute State of the Art. In der Session fängt der Mod einen Delegationsfehler beim Spawn ab und hält ihn für Sie an. Nach der Session geht der Fehler aus dem Log an claude-learn. Der Skill korrigiert den Trigger des Agent, die routing.json oder den Mod selbst, und die nächste Session routet denselben Prompt richtig.
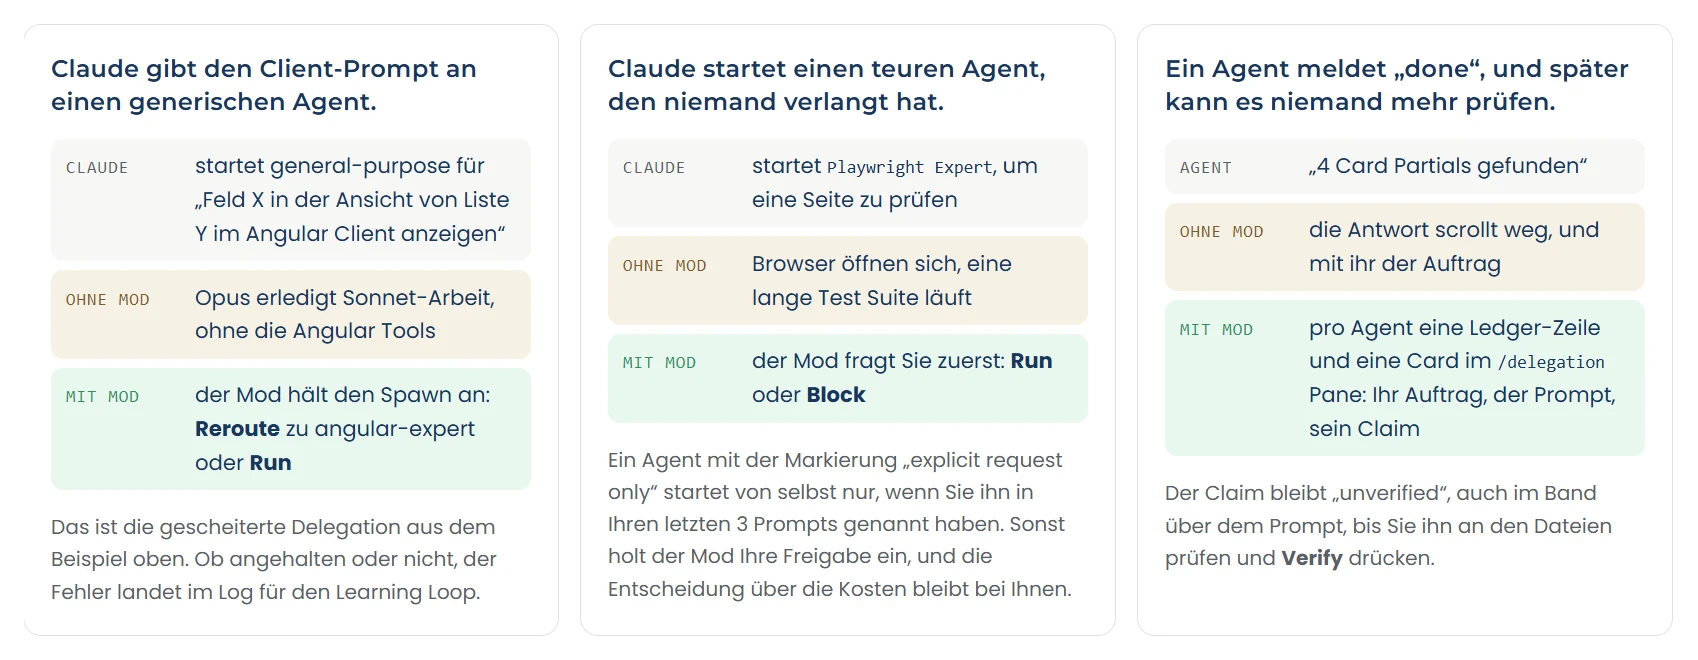
Der Mod fängt in der Session drei typische Fehler ab. Gibt Claude den Client-Prompt an einen generischen Agent, hält der Mod den Spawn an und bietet den Reroute zu angular-expert an. Startet Claude einen teuren Agent wie den Playwright Expert, den niemand verlangt hat, fragt der Mod zuerst nach. Meldet ein Agent „done“, landet der Claim im Ledger und bleibt offen, bis Sie ihn prüfen.
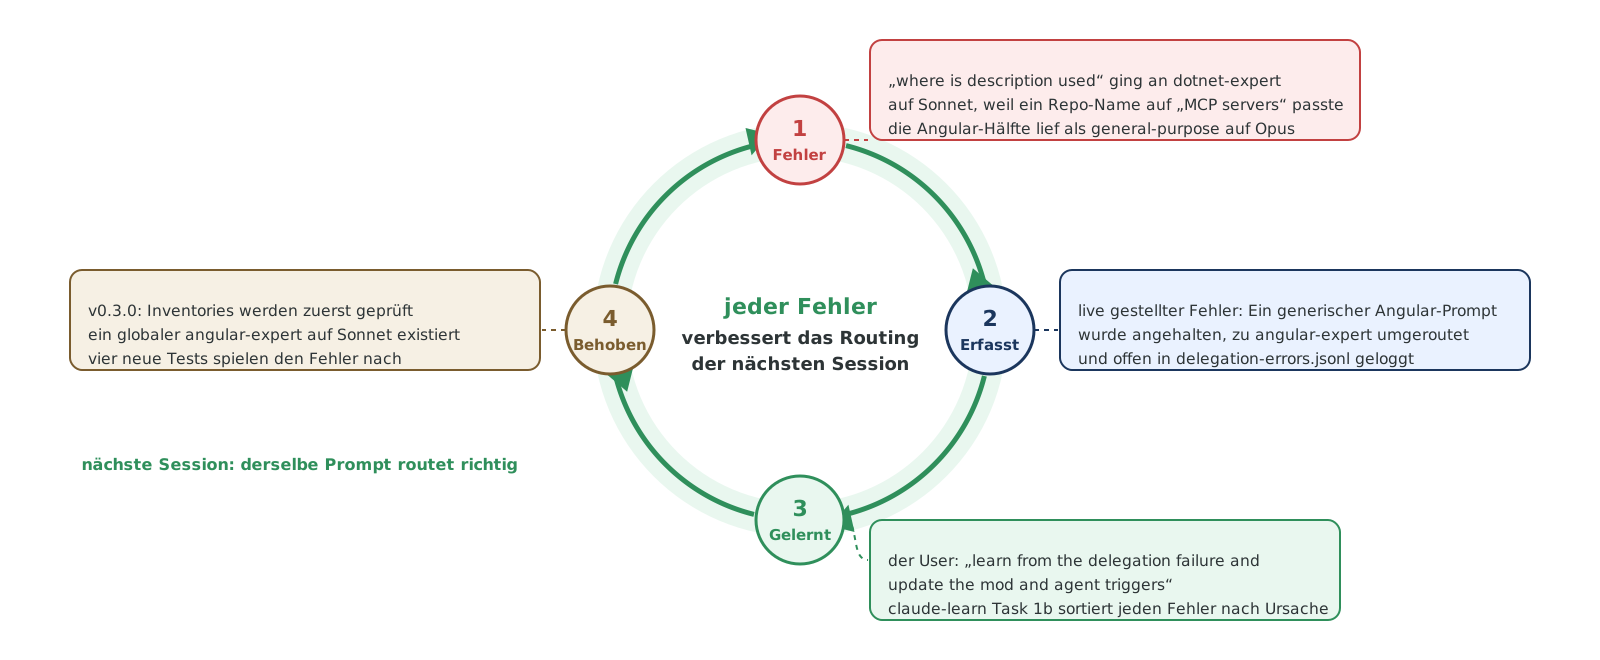
Nach der Session behebt claude-learn die Ursache. Im Beispiel landete ein Inventory bei dotnet-expert, weil ein Projektname auf das Keyword MCP Servers passte, und die Angular-Hälfte lief als General-purpose Agent auf Opus. Seit der Korrektur prüft der Mod Inventories zuerst, es gibt einen eigenen angular-expert auf Sonnet, und vier Tests spielen den Fehler nach, damit er nicht wiederkommt.
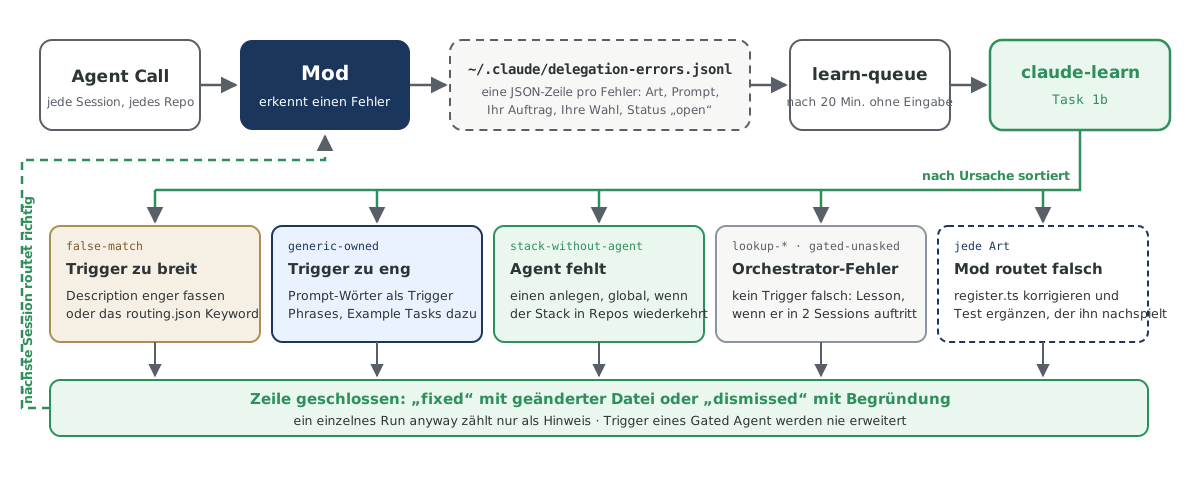
Jeder erkannte Fehler landet als offene Zeile im Log. Sobald 20 Minuten lang niemand etwas eingibt, startet learn-queue den Skill claude-learn. Er sortiert die Fehler nach ihrer Ursache: Ein zu breiter Trigger wird enger gefasst, ein zu enger bekommt zusätzliche Trigger Phrases, ein fehlender Agent wird angelegt, und ein Fehler im Mod wird mit einem Test behoben. Die nächste Session arbeitet schon mit den korrigierten Dateien.
Das /delegation Pane zeigt Modell, Kosten und offene Claims jedes Sub-Agent
Wer mit dem Orchestrator arbeitet, sieht den Main Thread. Die Sub-Agents arbeiten im Hintergrund: Welcher Agent welchen Prompt übernommen hat, auf welchem Modell, zu welchen Kosten und ob sein „done“ geprüft wurde, steckt im Transcript. Der Mod zeichnet ohnehin jeden Spawn, jeden Prompt, jeden Claim und jede Model Request auf. Das /delegation Pane stellt diese Aufzeichnung neben die Unterhaltung. Im Terminal ist es eine schlichte Textliste. Im Code Tab der Desktop App zeichnet das Pane einen Header mit den Tiles Cost, Tokens, Time und Unverified, eine Card pro Agent, gruppiert nach Running, Claimed und Verified, und eine Decisions Card mit den Reroutes.
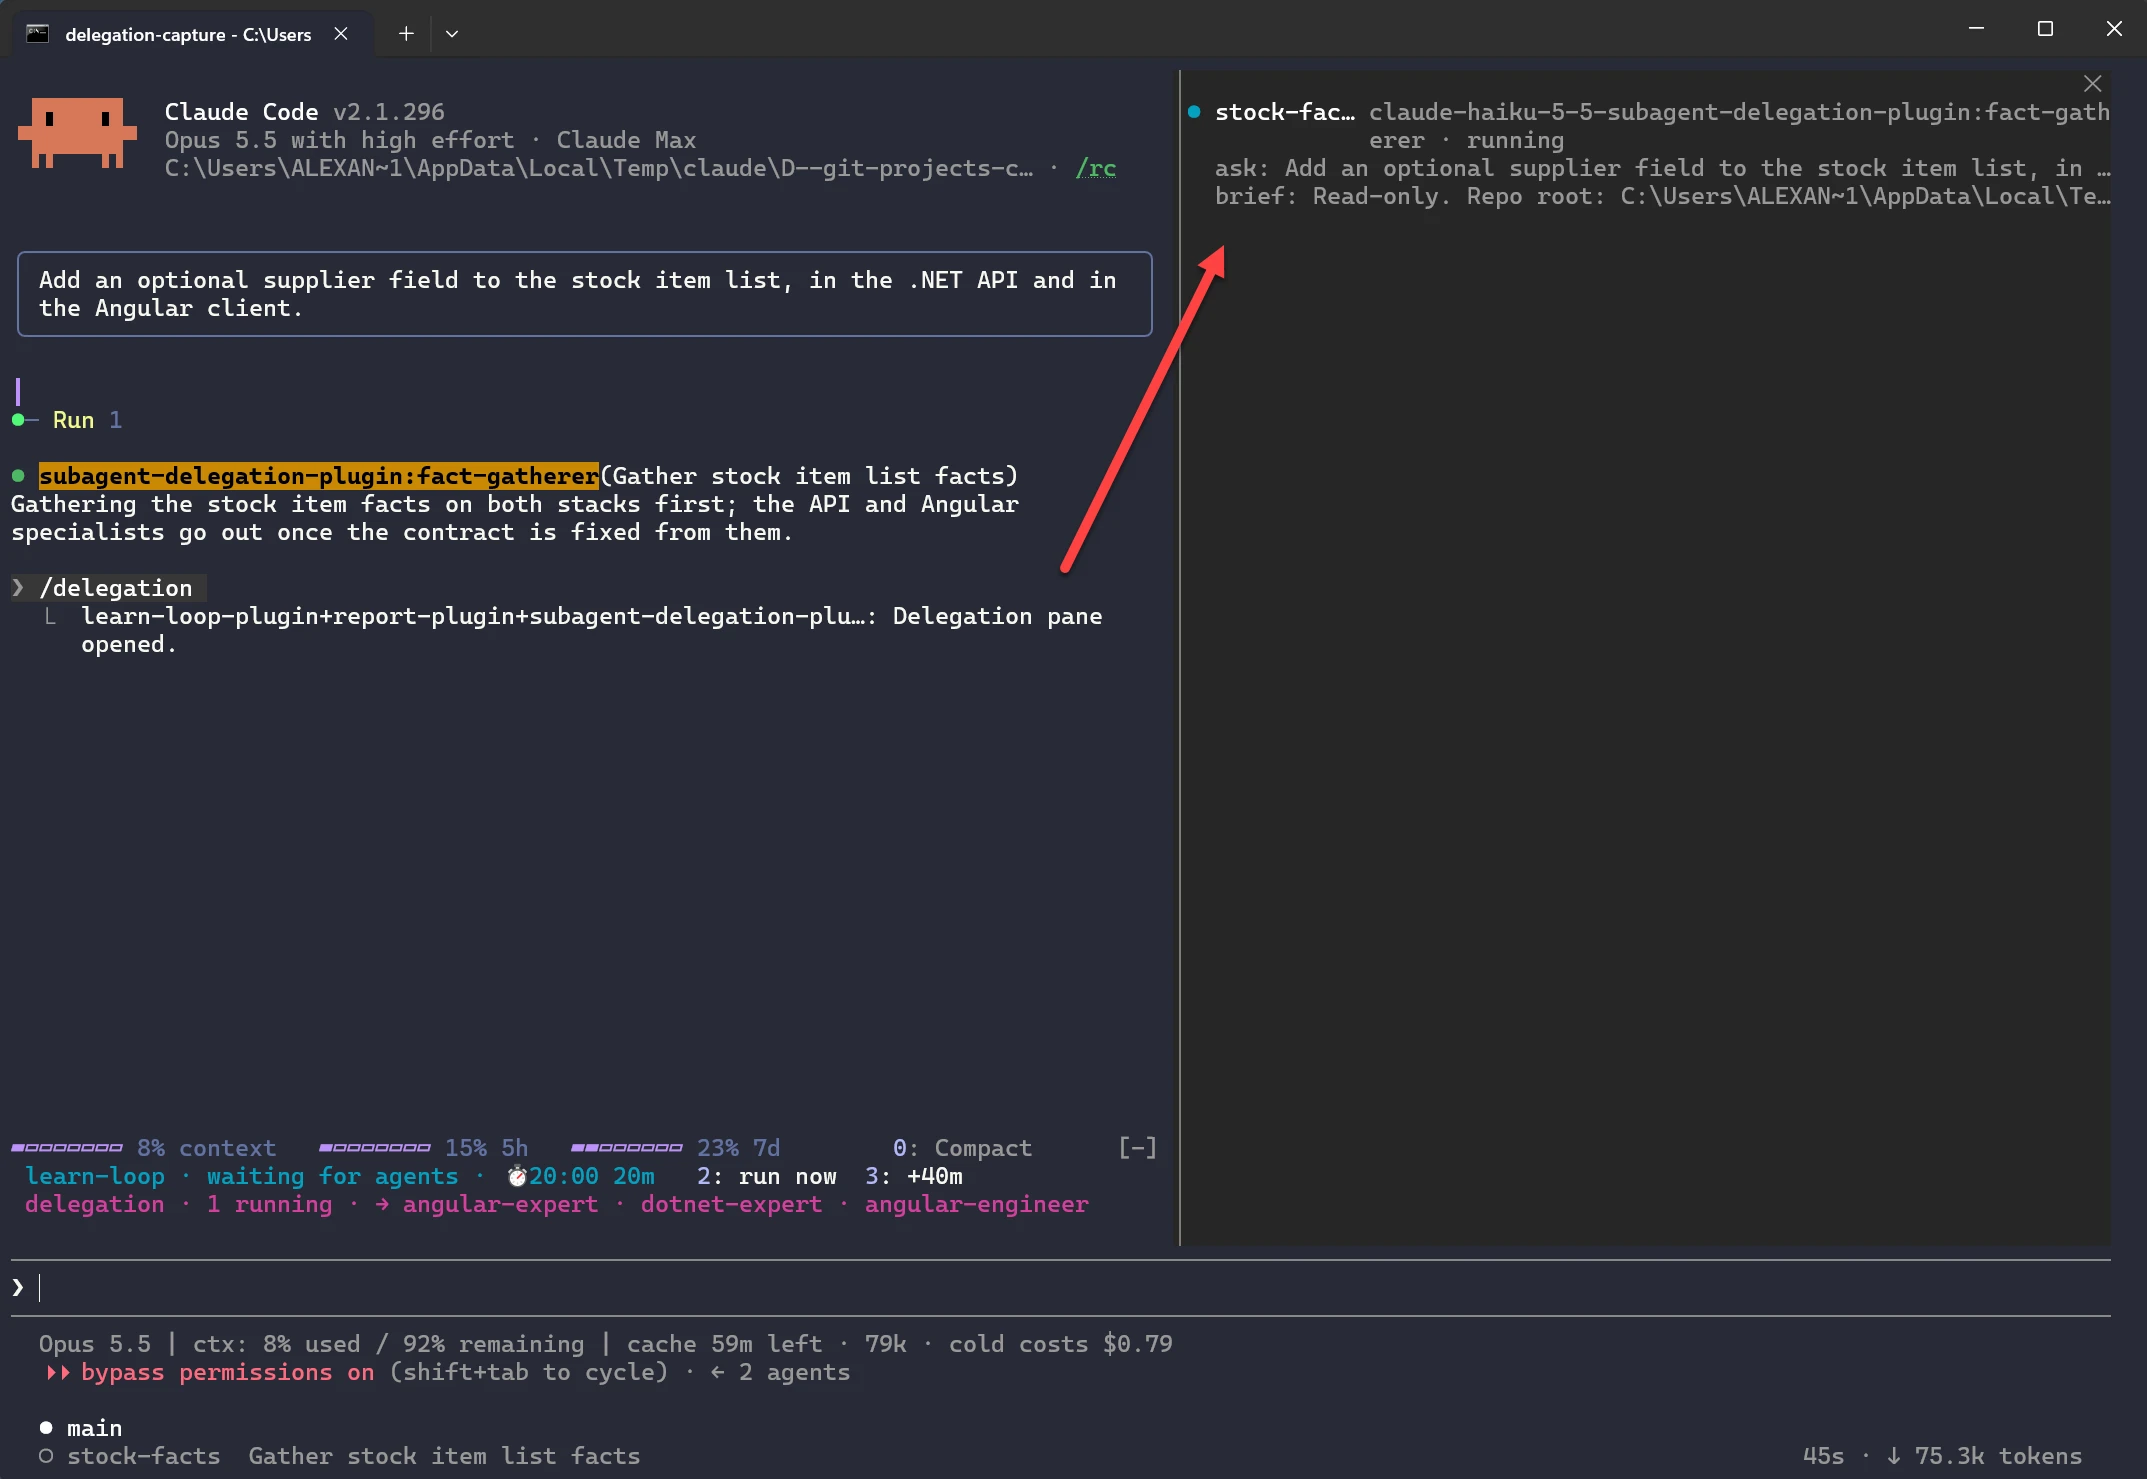
Bevor sich Code ändert, liest der fact-gatherer, wo Stock Items in der API und im Angular Client vorkommen. Er arbeitet nur lesend und auf dem günstigsten Modell, die Experts starten erst, wenn der Contract aus seinen Fakten feststeht. Das Band über dem Prompt zeigt einen laufenden Agent und die Specialists, die der Mod für den Prompt gefunden hat. Der Pfeil führt vom Befehl zum Pane: eine Zeile pro Agent mit Modell, Status, Ihrem Auftrag und dem Prompt, den er bekommen hat.
In der Claude Desktop App zeichnet der Mod dasselbe Pane mit einer eigenen UI. Dort sind Elemente möglich, die das Terminal nicht darstellen kann, etwa SVG-Grafiken. So lassen sich in der Desktop App deutlich reichhaltigere Panes bauen als im Terminal.
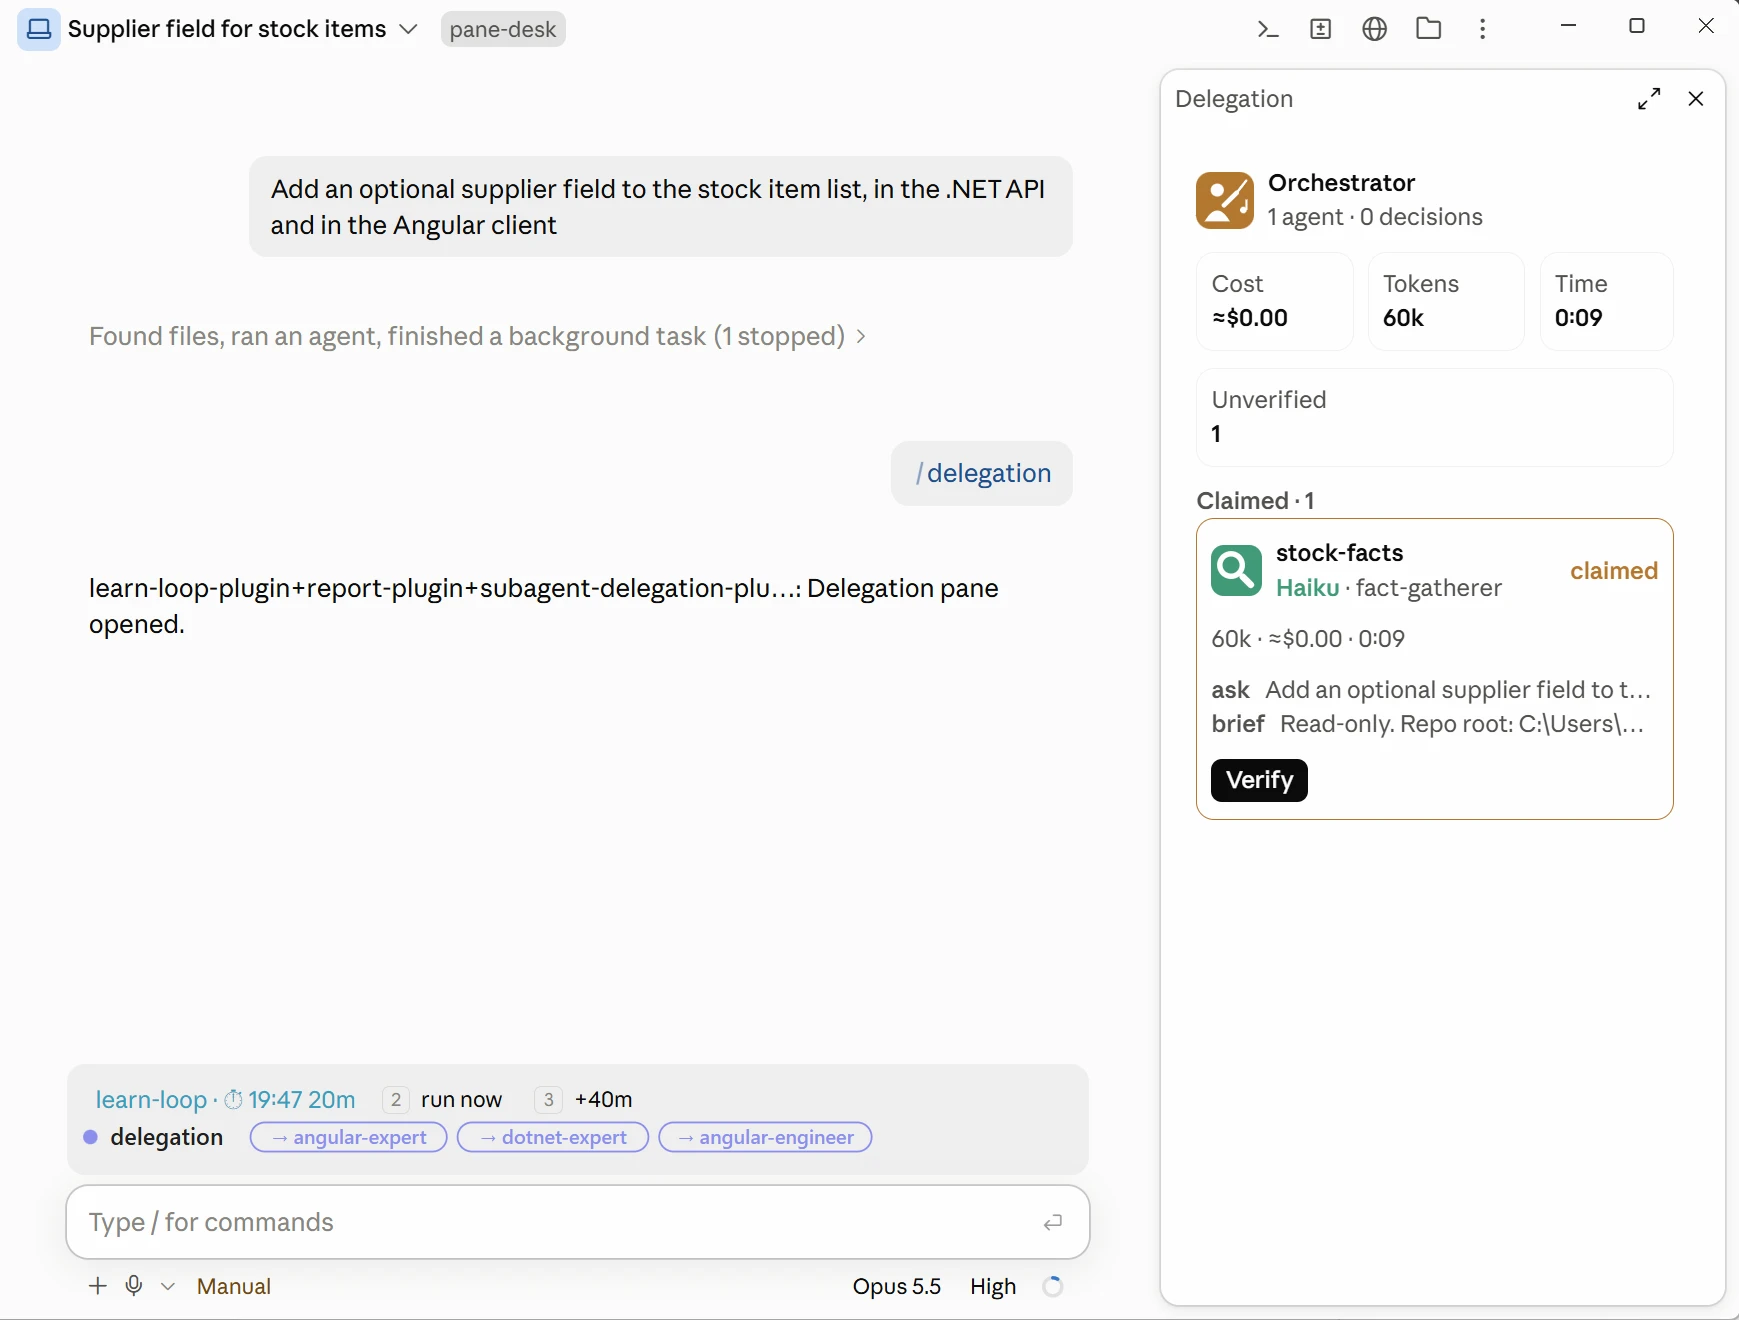
Die Tiles im Header summieren Kosten, Token und Zeit aller bisherigen Sub-Agents, Unverified zählt die Claims, die noch niemand geprüft hat. Die Kosten sind eine Schätzung: Der Mod rechnet die Token jeder Model Request mit dem Preis des jeweiligen Modells ab. Die Lupe markiert den fact-gatherer, und das Modell ist farbig: Haiku grün, Sonnet blau, Opus bernsteinfarben. Jede Card zeigt eigene Token, Kosten und Zeit, dann Ihren Auftrag, den Prompt und, sobald der Agent antwortet, die erste Zeile seiner Antwort. Ein fertiger Agent bleibt unter Claimed, bis Sie seinen Claim an den Dateien prüfen und Verify drücken; dann wandert er zu Verified.
So ist dieser Artikel entstanden: Die Benchmarks hat Alexander Kastil ausgewählt und überwacht, der Text wurde mit AI-Unterstützung geschrieben, und anschließend hat Alexander Kastil den Fokus neu ausgerichtet und Fehler korrigiert.
Weiterführende Links zu Mods, Sub-Agents und Orchestration
- Mods overview : was ein Mod ist, was er ändern kann und wo er läuft; Panes zeichnet er im Terminal und im Code Tab der Desktop App.
- Create custom subagents : Agent-Dateien mit Modell, Tools und Description, die Preisstufe und Expertise jedes Specialist festlegen.
- How we built our multi-agent research system : Anthropic über einen Lead Agent, der parallele Sub-Agents koordiniert, mit Prompts, Tool-Auswahl und Evaluation.
- Building effective agents : Anthropic über Orchestrator-Workers und andere kombinierbare Patterns, und wann ein Workflow besser passt als ein autonomer Agent.
- Hooks reference : Settings Hooks wie PostToolUse und UserPromptSubmit, auf die sich die Regeln zur Delegation vor den Mods stützten.
- React to events : einen Tool Call bewachen oder umschreiben und einem Turn folgen, der Mechanismus hinter dem Anhalten und dem Reroute eines Agent Call.
- Draw in the interface : Panes, das Band über dem Prompt, Buttons und State, wie sie das /delegation Pane und sein Verify Button nutzen.
- Plugins overview : Plugins, Marketplaces und Install Scopes, über die ein Marketplace den Mod und seine Fixes an jedes Repository verteilt.